
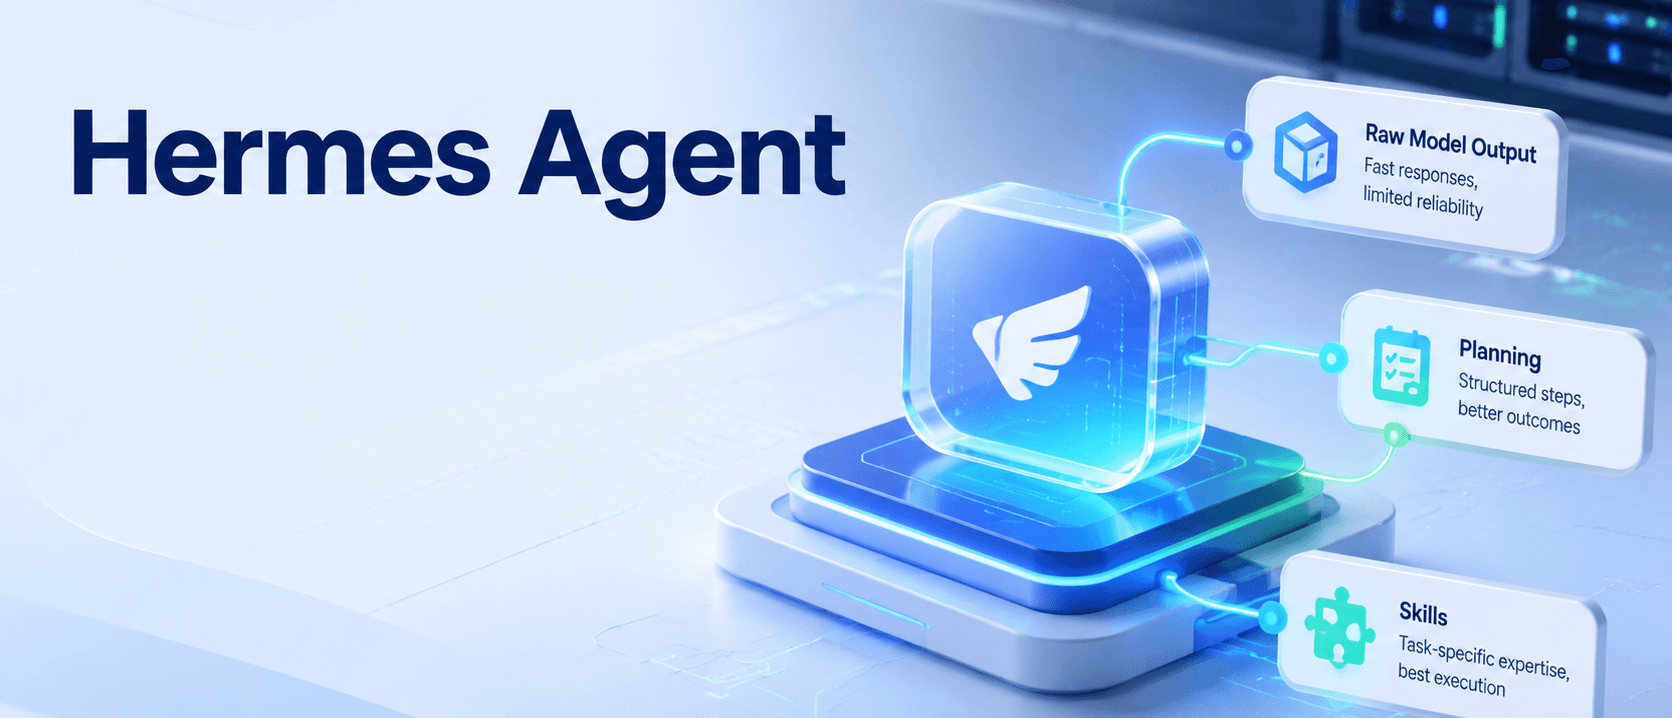
Hermes Agent 的表现取决于两件事:你选择的模型,以及附着到任务上的 Skills。把模型想成执行引擎;Skill 则是任务剧本,告诉系统如何规划、使用哪些工具、遵循何种输出格式,以及执行边界在哪里。
初学者常把智能体当成更强的聊天框。他们粘贴任务、等待输出,只凭最终结果评判模型。这对简单任务够用。当工作需要规划、工具调用、版式判断、浏览器上下文、移动端执行或反复审阅时,就会崩塌。
核心要点
- Hermes Agent 质量同时取决于模型能力与 Skill 设计
- Skill 把通用模型变成任务专用执行器
- 执行前先规划,可减少跑偏与返工
- 同一输入在原始、规划优先与 Skill 驱动工作流下,结果可能截然不同
- 团队应检查输入、计划、运行证据、输出与审阅状态
Hermes Agent 的简单思路
把引擎与剧本分开,Hermes Agent 更容易理解。一层提供推理、工具调用、多模态理解与长任务稳定性;Skill 提供方法。
没有 Skill,模型凭通用经验猜测工作流。有了 Skill,模型获得更清晰路径,可少花力气决定「怎么做」,多花力气把任务做好。
这对真实运营很重要。增长团队可能需要准备内容、打开浏览器会话、选择正确账号、路由素材、检查移动端界面并记录证据。在这种场景下,AI 浏览器或移动执行层只有在智能体也理解工作流时才真正有用。
为什么一次测试改变了对模型的判断
源文章从一个常见体验开始。用模型做一个简单的 H5 工具页,输出还可以。再用同一模型做自我介绍 PPT,结果显得扁平、松散,一眼看出是 AI 生成。
更好的解读不是「模型不行」,而是这次运行没有收到好的工作流。它被要求把材料变成幻灯片,却缺少足够结构、版式指引与审阅点。
第二次尝试用同一模型,加上面向 PPT 的 Skill,结果显著变化。模型质量设定上限,但 Skills 帮助模型在具体任务中触达该上限。
模型控制什么
模型选择决定智能体能否把工作推理清楚。更强模型通常更擅长更深规划、工具调用、图像、长上下文与多步执行。较弱模型可能漏步骤、调错工具,或偏离要求输出。
这不意味着每个任务都要用最贵设置。团队应按工作匹配模型。短重写与浏览器工作流、多账号任务或幻灯片生成任务的需求不同。
在运营中,可靠性往往比单次惊艳回答更重要。能稳定遵循工具与计划的模型,可能比写出漂亮段落却丢失任务状态的模型更有用。
Skills 控制什么
Skills 控制智能体如何工作。Skill 可定义步骤、工具、输出形态、文件规则、校验检查与恢复行为。它把模糊指令变成可重复程序。
例如,PPT Skill 可告诉模型如何搭建结构、处理层级、选择版式模式并管理幻灯片节奏。浏览器 Skill 可告诉模型如何检查页面、安全操作并记录证据。移动自动化 Skill 可定义应用专属界面内应发生什么。
移动自动化、设备隔离与多账号管理映射的是同一思路:执行系统需要受控环境,也需要受控方法。
测试 A:把材料直接交给模型
第一次测试中,模型收到文章内容,并在没有额外指引的情况下被要求做 PPT。这是最常见的初学者工作流,对复杂工作也最弱。
输出或许可用,但往往缺乏层级。模型可能压缩错重点、过度解释弱点,或做出感觉通用的版式。工作做完了,但还没准备好面向专业受众。
问题不只是视觉质量。更深问题是:没人定义任务路径。在测试 A 中,系统必须同时决定幻灯片数量、叙事流、视觉优先级与输出标准。
测试 B:先规划,再执行
第二次测试中,模型先阅读材料并创建执行计划。计划定义要做多少页、每页说什么、版式如何运作,以及哪些点值得强调。
这一步创造检查点。人可以在执行开始前审阅计划。若任务方向错了,团队可尽早修正,而不是事后修补成品。
规划也改善团队运营。管理者可审阅步骤、确认账号范围、检查数据源并批准运行。这比让智能体像黑盒一样操作更安全。
测试 C:先规划,再用 PPT Skill 执行
第三次测试在规划后加入 PPT Skill。现在模型不仅被告知要做什么,还获得了任务专用做法。
输出因此改变。运行可遵循版式模式、视觉节奏、层级规则与数据呈现规则。它不再需要在执行中发明整条工作流。
这就是 Skills 对运营重要的原因。内容再用途 Skill、审阅回复 Skill、账号检查 Skill 或周报 Skill,都能沉淀团队经验。因为方法明确,执行更一致。
A/B/C 结果对比
源文章对比了三张最终封面。差异一目了然:同一材料、同一模型、不同运营方法。
测试 A 是原始执行,设置最少,质量风险最高。测试 B 加入规划,结构改善。测试 C 加入 Skill,工作流更贴任务,输出也更易信任。
实践教训:不要只凭模型名称评判智能体。评判完整工作流——模型、Skill、计划、环境、输出与审阅。行动前先检查,尤其当运行可能触及文件、浏览器状态、账号或公开界面时。
团队为何在 Hermes Agent 上失败
团队失败往往因为跳过规划层。他们要求模型立刻执行,然后只检查最终结果。这种方法会把错误隐藏到修正成本很高时才暴露。
复杂工作有许多隐形选择。幻灯片需要故事、页节奏、版式、视觉优先级与一致性检查。浏览器任务需要会话状态、目标选择、页面检查、动作日志与恢复规则。
若智能体起步就错,往往一路错下去。规划检查点让操作员在运行消耗时间或触碰真实账号前纠正路径。
对重度浏览器团队,浏览器使用更需要上下文纪律。运行应知道它在使用哪个账号、标签页、素材与任务记录。否则自动化很难审阅。
如何选择合适的模型与 Skill
从任务难度起步。简单写作任务未必需要高推理设置。多步任务、浏览器任务、图像感知任务与长工作流需要更强稳定性,因为漏一步就可能污染后续运行。
然后选择匹配任务类型的 Skill:
- PPT 工作需要幻灯片 Skill
- 网页检索需要浏览器 Skill
- 社媒运营可能需要内容、账号与审阅 Skills
- 通用提示不应承载每条工作流
最后,检查工作流是否可审阅。有用的 Skill 应产出或支持计划、证据、输出、错误备注与下一步建议。
| 问题 | 好答案 | 风险信号 |
|---|---|---|
| 任务类型是什么? | 清晰类别,如幻灯片、浏览器、摘要或移动运行 | 模糊的「用 AI 做这个」请求 |
| 需要什么模型? | 与工具使用和任务长度匹配 | 只按成本或热度选择 |
| 适用哪个 Skill? | 有清晰步骤的任务专用 Skill | 仅有通用提示 |
| 谁审阅计划? | 执行前的具名审阅者 | 无检查点 |
| 用什么证明完成? | 输出加证据或运行记录 | 只有最终回答 |
面向团队的实用 Hermes Agent 设置
团队应把教训变成可重复设置。不要先问「哪个模型最好?」先命名工作通道。
例如,社媒运营团队可定义内容再用途通道。输入是一份长源素材、品牌备注、目标渠道、账号组与审阅负责人。输出是一组渠道草稿、风险备注与发布清单。Skill 应告诉智能体如何拆分素材、调整语气、避免无依据主张,并标记需要人工批准的项目。
浏览器任务通道需要不同字段:目标站点、账号工作区、允许动作、停止条件、截图规则与恢复规则。移动任务通道需要设备组、应用状态、账号负责人、动作限制与证据格式。
每次运行前使用简短字段清单。对本文源工作流,实践清单很具体:3 种测试模式、若干保留媒体资产、7 个运行字段,以及 5 项通过/失败检查。
| 字段 | 为何重要 | 示例 |
|---|---|---|
| 任务通道 | 选择正确 Skill | 幻灯片创建、浏览器检索、账号检查 |
| 输入来源 | 防止模糊执行 | 文章 URL、内容简报、后台导出 |
| 环境 | 保持上下文隔离 | 浏览器配置、云手机、设备组 |
| 允许动作 | 防止越权 | 只读、只草稿、不发布 |
| 审阅负责人 | 建立问责 | 增长负责人、编辑、客户经理 |
| 证据 | 让完成可检查 | 截图、文件路径、运行备注 |
| 停止规则 | 控制风险 | 登录变更或公开动作前先询问 |
这套设置不是官僚主义。它是有用智能体与随机助手之间的差别。字段稳定后,Skill 可在多次运行中复用它们。
需要留意的失败模式
Hermes Agent 工作通常以可预期方式失败。把这些当作运行前检查。
| 失败模式 | 表现 | 修复 |
|---|---|---|
| 输入模糊 | 有目标,但缺少来源、输出格式与审阅规则 | 要求任务简报 |
| 工具跑偏 | 错误页面、错误账号或页面状态被改变 | 命名浏览器上下文 |
| 格式跑偏 | 幻灯片、摘要或社媒草稿忽略所需结构 | 增加格式检查 |
| 缺少证据 | 审阅者无法检查发生了什么变化 | 保存截图或运行备注 |
| 检查 | 通过 | 失败 |
|---|---|---|
| 计划质量 | 步骤清晰到人可批准 | 计划只是模糊摘要 |
| Skill 匹配 | Skill 匹配任务通道 | 通用提示包办一切 |
| 环境 | 账号、浏览器或设备已命名 | 智能体依赖当前上下文 |
| 输出 | 格式可审阅 | 输出需要全面重写 |
| 证据 | 结果有截图、文件或运行备注 | 只有最终文本 |
若有两项检查失败,暂停工作流。在用于生产前,改进 Skill 或收窄任务。
真实运行的 Hermes Agent 审阅规则
真实运行需要在执行开始前就有审阅规则。当任务超出文本、触及浏览器会话、上传、文件或账号状态时尤其如此。Chrome DevTools 文档的浏览器参考显示同一工程模式:动作需要明确会话、目标与可观察状态。
对 Hermes Agent 运行,使用 4 道审阅关卡:
| 关卡 | 审阅重点 |
|---|---|
| 1 | 输入来源与任务范围 |
| 2 | 计划、边界与停止规则 |
| 3 | 执行证据 |
| 4 | 最终输出与重试备注 |
审阅者应回答:输入来源是否已命名;账号或环境是否已命名;Skill 是否匹配任务通道;公开动作是否在批准前被阻止;是否有完成证明;是否有回滚或重试备注。
这些规则简单,却能防止常见失败:智能体完成了任务,却没人能安全核验。
Hermes Agent 与增长运营
对增长团队,当 Hermes Agent 成为重复工作的一部分时才真正有用。团队可能再用途内容、准备帖文、检查账号状态、运行后台任务或产出周报。
这些任务不应只活在聊天里。它们需要内容库、账号归属、设备或浏览器路由、审阅状态与证据。当工作从规划进入真实账号或应用界面时,社媒运营与云手机层就很相关。
正确模式很简单:规划、执行、记录、审阅、改进。Skill 应让该模式更易重复。
Hermes Agent 初学者运营清单
- 在选择模型前定义输入
- 要求智能体在执行前给出计划
- 将 Skill 匹配到任务类别
- 在智能体触及真实账号或文件前审阅计划
- 为浏览器、移动端或账号动作保留证据
- 记录失败内容,并把修复写入下一版 Skill
清单让 Hermes Agent 工作不再变成随机试错。它也给团队公平比较模型的方式:模型应在可重复工作流内被评判,而不是仅凭一次原始提示。
常见问题
Hermes Agent 主要是选最强模型吗?
不是。模型质量重要,但工作流同样重要。没有 Skill 的强模型可能产出可用但通用的结果;有好 Skill 的模型可遵循更清晰路径,团队也能在执行前检查。
Skill 实际做什么?
Skill 定义运营方法。它可以定义步骤、工具、输出格式、校验规则与恢复行为。
每个任务都应先规划吗?
多数多步任务应当如此。规划在智能体花费时间、编辑文件、打开账号或运行工具前创造检查点。短任务短计划;高风险任务要明确计划。
为什么用 Skill 后 PPT 结果更好?
Skill 为运行提供了幻灯片结构、版式、视觉层级与执行节奏的具体指引,消除了运行中的猜测。
团队应如何测试新 Skill?
用同一输入做三次运行:原始模型、规划后执行,以及规划后加 Skill 执行。在一张表中比较质量、错误、返工与审阅工作量,让决策基于可见差异。
何时浏览器或移动端执行很重要?
当工作流离开文本、触及账号、后台、上传、应用或设备特定状态时,它就重要。此时环境隔离与运行证据变得关键。
Skills 如何随时间改进?
团队应记录失败、边界情况与审阅者修改。这些备注会成为下一版 Skill 中更好的指令、检查与恢复规则。